
Tantangan Pemrosesan Teks Bahasa Indonesia
Teks opini di media sosial Indonesia penuh dengan kata tidak baku, singkatan, dan pencampuran bahasa. Proyek Sentimen IndoNLP ini berfokus pada pipeline preprocessing yang akurat sebelum teks dimasukkan ke algoritma klasifikasi.
Tahapan Pipeline
- Text Preprocessing: Case folding, normalisasi kata slang, tokenisasi, stopword removal, dan stemming Bahasa Indonesia.
- Feature Extraction & Modeling: Pembobotan TF-IDF dan evaluasi metrik Precision, Recall, serta F1-Score.
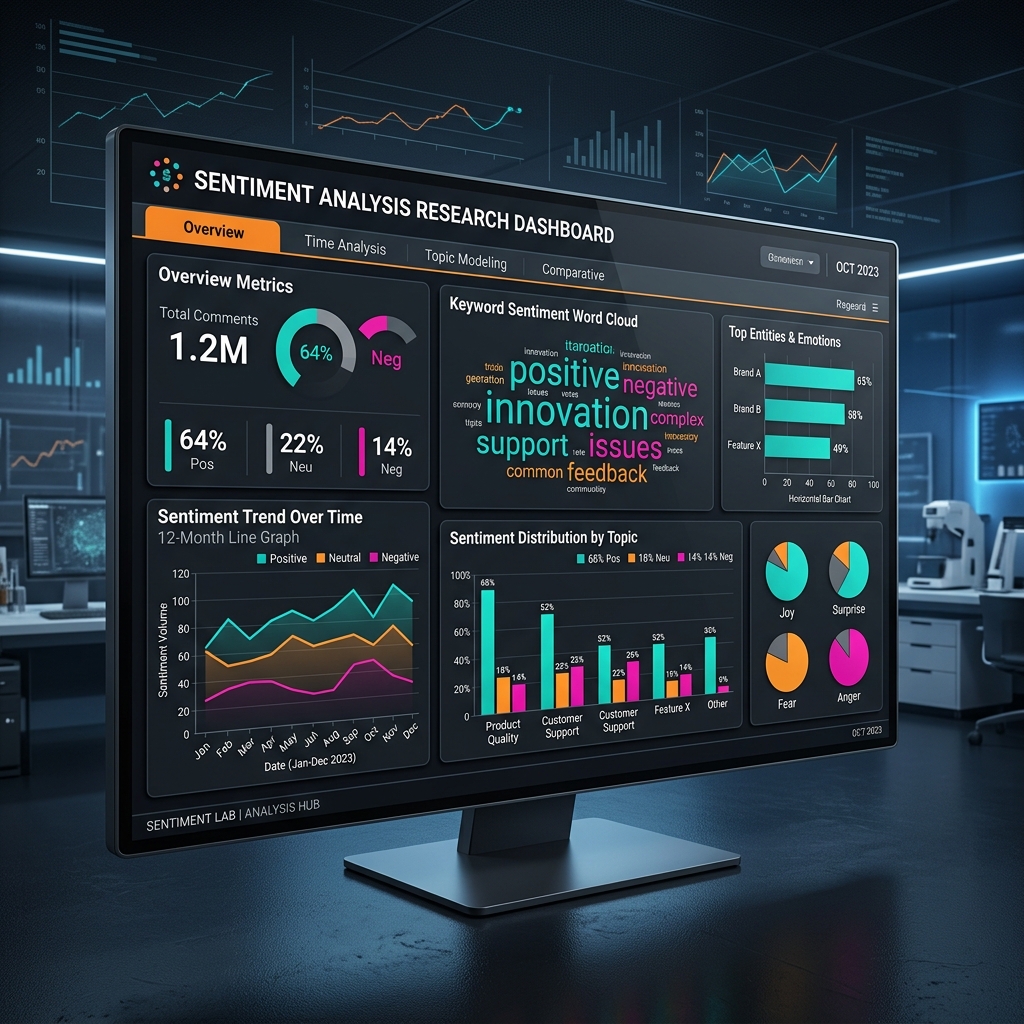
- Interactive Web Dashboard: Dibangun dengan Flask (Python) untuk menyajikan grafik distribusi sentimen positif, netral, dan negatif.